01电脑真的“认识”中文吗?
我们平时会说:“电脑认识汉字。” 但更准确地说,电脑并不是像人一样看到“中”就理解“中”的意思。
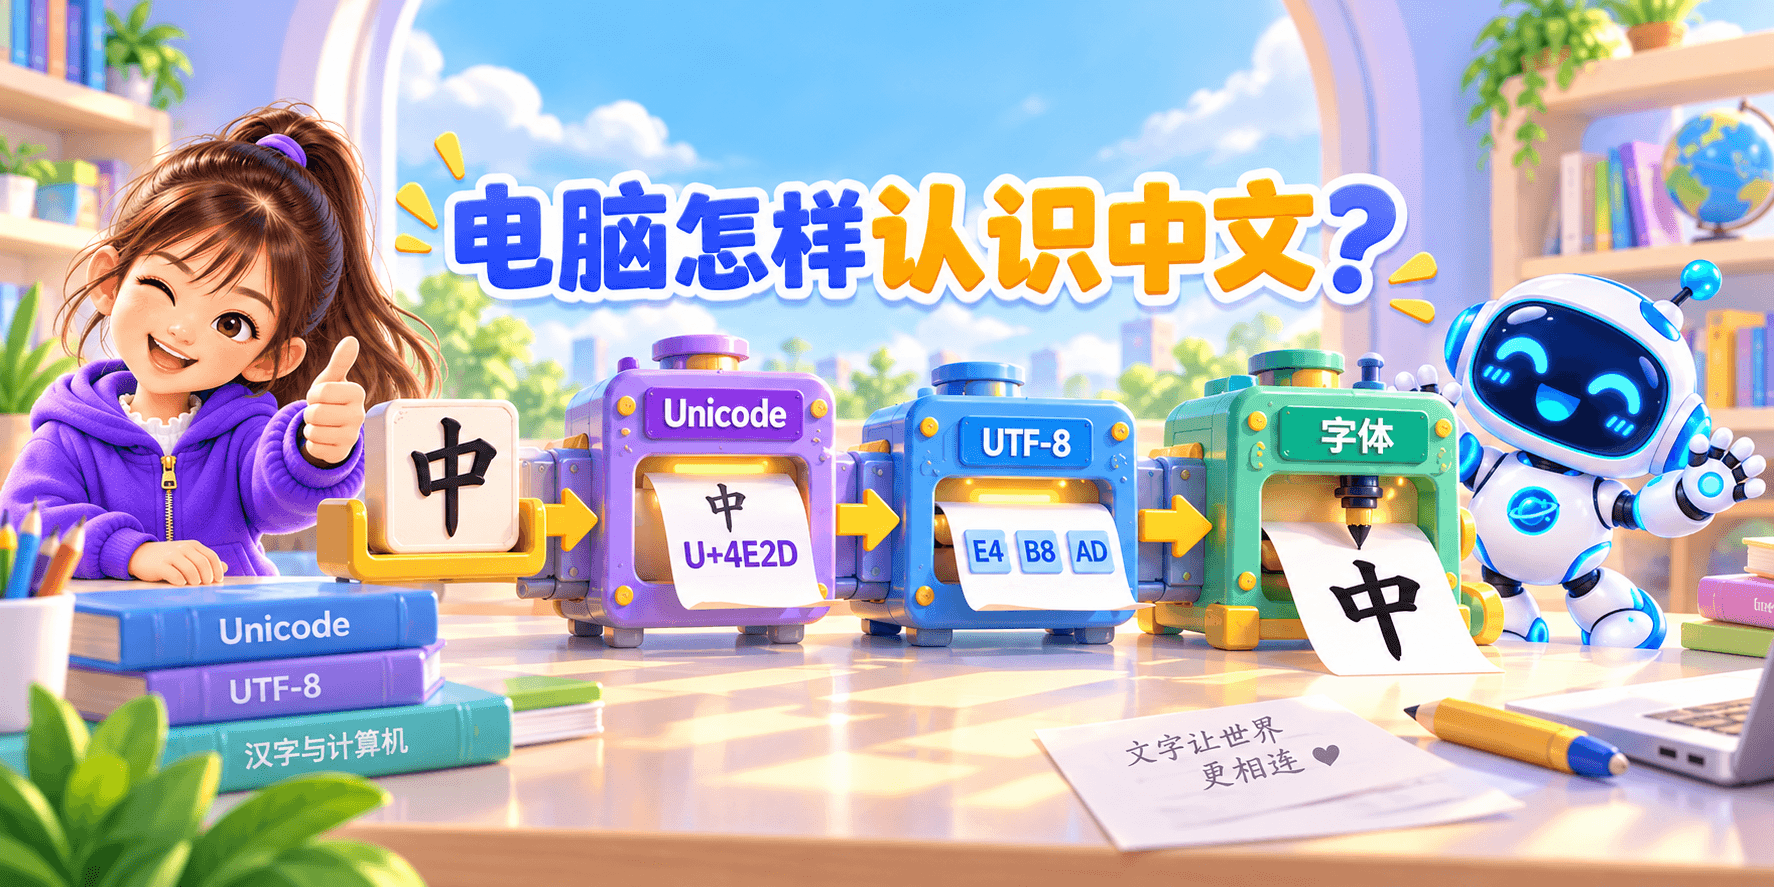
电脑做的是: 按照约定,把字符对应到编号,再把编号编码成数据进行保存、传输和显示。
字符
我们看到的汉字
Unicode 码点
这个字符的统一编号
E4 B8 AD
UTF-8 字节
真正保存的数据
02汉字先要有一个统一编号
中文里有大量汉字。 如果每台电脑都自己给汉字编号,不同设备之间就会乱套。
所以 Unicode 给大量字符分配统一的 码点(Code Point)。
汉字“中”
汉字“国”
汉字“你”
汉字“好”
03编号怎样变成真正保存的 Byte?
Unicode 码点只是字符编号。 文件和内存真正保存的是 Byte。
UTF-8 就是一种把 Unicode 码点变成字节序列的编码方式。
E4 B8 AD
3 Byte
在 UTF-8 中,常见汉字通常占 3 Byte。 但这不是说“汉字天生就是 3 Byte”,而是 UTF-8 对这些码点的编码结果。
04我们打拼音时,汉字是怎么出来的?
当你在键盘上输入 zhong,
键盘并不会直接产生“中”这个汉字。
中文输入法会根据你输入的按键、拼音规则、上下文和候选词模型, 给出可能的汉字或词语。
键盘输入
输入法
把按键序列转换成候选字符
候选词
05电脑怎样把“中”画到屏幕上?
电脑知道当前字符是 U+4E2D 以后, 还需要知道:这个字到底应该画成什么样?
这就需要字体(Font)。 字体中保存了字符对应的字形设计信息。
字体
找到这个字符对应的字形
屏幕上的字形
操作系统和文字渲染系统会根据字体中的字形信息, 再结合字号、抗锯齿、屏幕像素等条件,把字画到屏幕上。
06为什么同一个汉字可以长得不一样?
因为不同字体会给同一个字符设计不同的字形。
宋体风格
笔画有明显粗细变化
黑体风格
笔画更简洁、均匀
等宽风格
常用于代码编辑器等场景
07中文乱码为什么会出现?
中文字符通常需要多个 Byte。 如果保存和读取时使用了不同编码,就很容易出现乱码。
E4 B8 AD
过去中文环境里还使用过 GB2312、GBK、Big5 等编码。 今天 Unicode / UTF-8 已经非常普遍,但旧文件和旧系统仍可能使用其他编码。
你已经知道了什么
- 电脑“认识中文”并不是像人一样理解汉字含义,而是按照字符编码规则处理数据。
- Unicode 会给大量字符分配统一码点,例如“中”是 U+4E2D。
- Unicode 码点不是最终存储字节,UTF-8 等编码负责把码点变成 Byte。
- UTF-8 中常见汉字通常占 3 Byte,但“汉字 = 3 Byte”不是普遍规律。
- 中文输入法负责把拼音、按键和上下文转换成候选字符,它和字符编码不是一回事。
- 字体负责提供字符的字形,字符本身和它在屏幕上的样子不是一回事。
- 同一个汉字在不同字体里可以长得不同,但码点仍然相同。
- 中文乱码常常来自保存和读取时使用了不同字符编码。
下一个问题: 文字可以编码成数字, 那一张彩色图片在电脑里面到底是什么? 下一篇:一张图片在电脑里是什么?