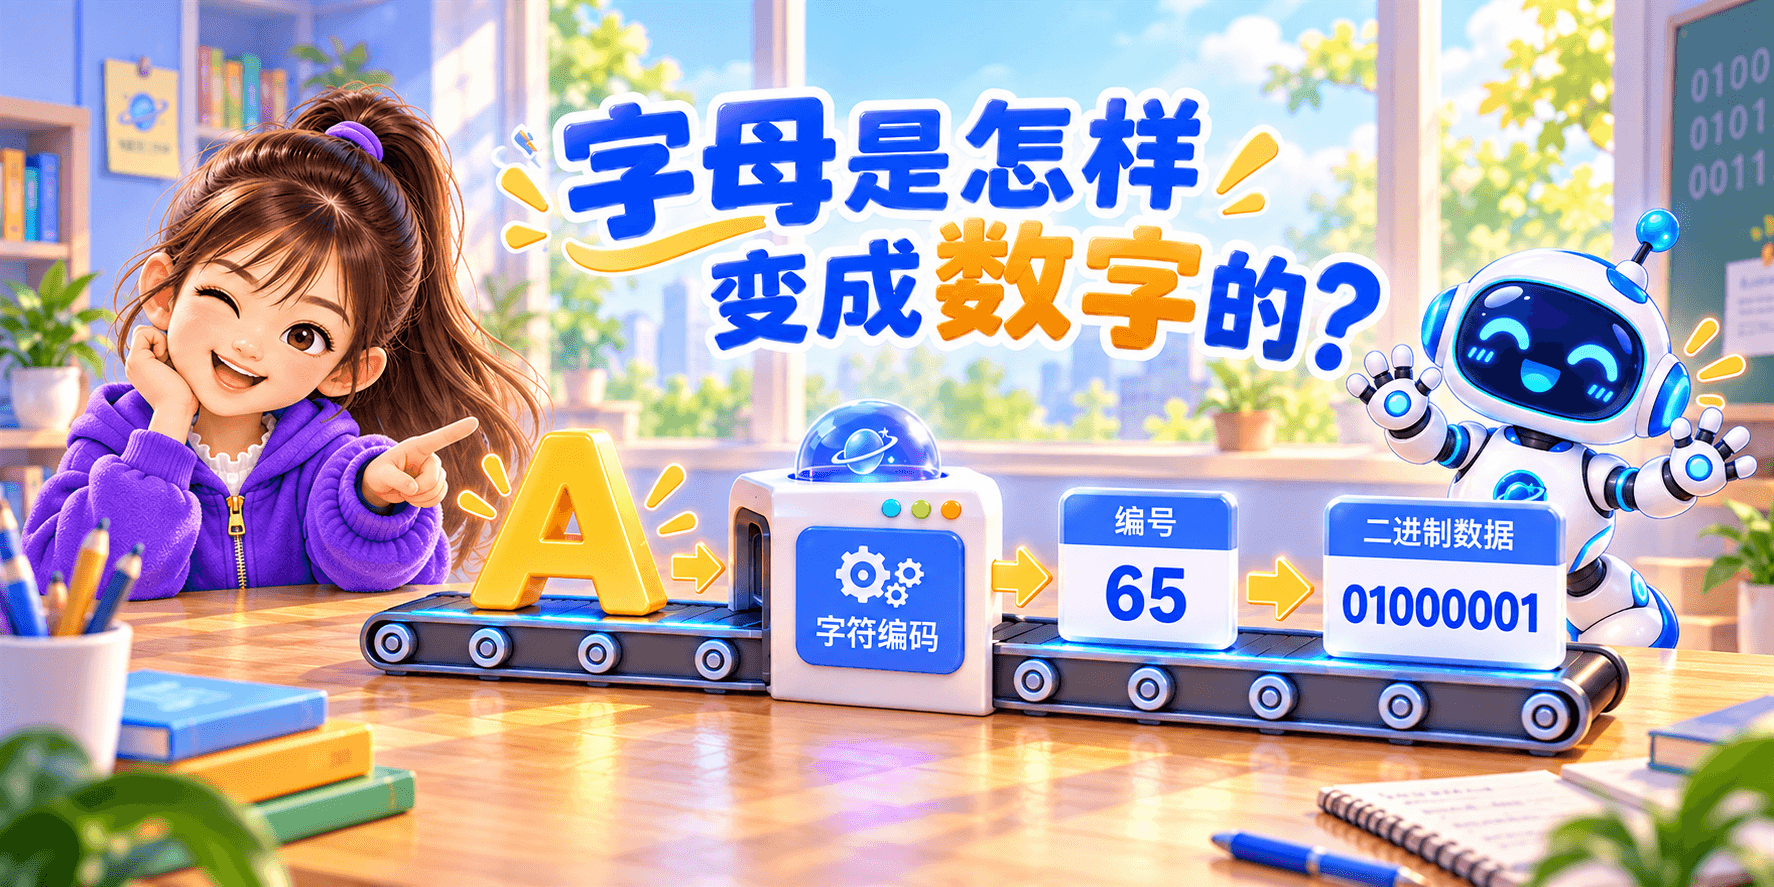
01电脑为什么要把字母变成数字?
我们看到的是字母 A、B、C, 但电脑真正保存和处理的,仍然是一串 Bit。
所以必须先约定一套规则: “每个字符对应哪个编号?”
字符
人看到的符号
编号
按照某种字符编码规则
01000001
二进制数据
最终保存进电脑
02ASCII 是怎么给字母编号的?
早期计算机主要处理英文文字, 人们制定了一套著名的字符编码标准: ASCII。
ASCII 会给英文字母、数字、标点和一些控制字符分配编号。
01000001
01000010
01000011
01100001
例如,大写字母 A 的 ASCII 编号是 65。
如果保存成 8 Bit,就可以写成 01000001。
03字符和编号是一回事吗?
不是。 这是理解字符编码最重要的地方之一。
字符 Character
例如字符“A”
编号 / 码点
给这个字符分配的数字编号
实际字节
编码成文件或内存中的具体 Byte
04只有英文字母够不够?
当然不够。 世界上还有中文、日文、韩文、阿拉伯文、各种符号和 Emoji。
所以后来出现了 Unicode, 它试图为世界上大量字符分配统一的 码点(Code Point)。
U+0041
拉丁字母 A
U+4E2D
汉字“中”
U+4F60
汉字“你”
U+1F600
一个 Emoji
05UTF-8 又是做什么的?
UTF-8 是一种把 Unicode 码点 编码成字节序列的方法。
它的特点之一是: 不同字符可能使用不同数量的 Byte。
41
十六进制表示
E4 B8 AD
UTF-8 中的三个字节
06同一个字符为什么可能占不同字节?
因为“字符是什么”和“怎样编码存储”是两层不同的问题。
例如字符 A 的 Unicode 码点是 U+0041, 但采用不同编码方式时,实际保存的字节序列可以不同。
UTF-8
41
1 Byte
UTF-16LE
41 00
2 Byte
UTF-32LE
41 00 00 00
4 Byte
07乱码是怎么来的?
如果一段字节原本是按照 UTF-8 保存的, 却被程序按照另一种编码去解释, 就可能显示成奇怪字符。
E4 B8 AD
你已经知道了什么
- 电脑保存字母时,会先把字符映射到数字编号,再保存成二进制数据。
- ASCII 是早期非常重要的字符编码,A 的 ASCII 编号是 65。
- 字符、字符编号(码点)和实际存储字节不是同一件事。
- Unicode 为世界上大量字符分配统一码点,例如 A 是 U+0041,“中”是 U+4E2D。
- UTF-8 是把 Unicode 码点编码成具体字节序列的一种方式。
- UTF-8 中 ASCII 字符通常占 1 Byte,常见汉字通常占 3 Byte。
- 同一个字符在 UTF-8、UTF-16、UTF-32 等编码中占用的字节数可能不同。
- 乱码常常来自“写入时和读取时使用了不同字符编码”。
下一个问题: 英文字母可以编号, 那成千上万个汉字又是怎样被电脑认识和保存的? 下一篇:电脑怎样认识中文?