一起动脑筋 · 先看一个小故事
女孩拍手、说话、敲铃,机器人收到的都是声音,但处理目标不同。
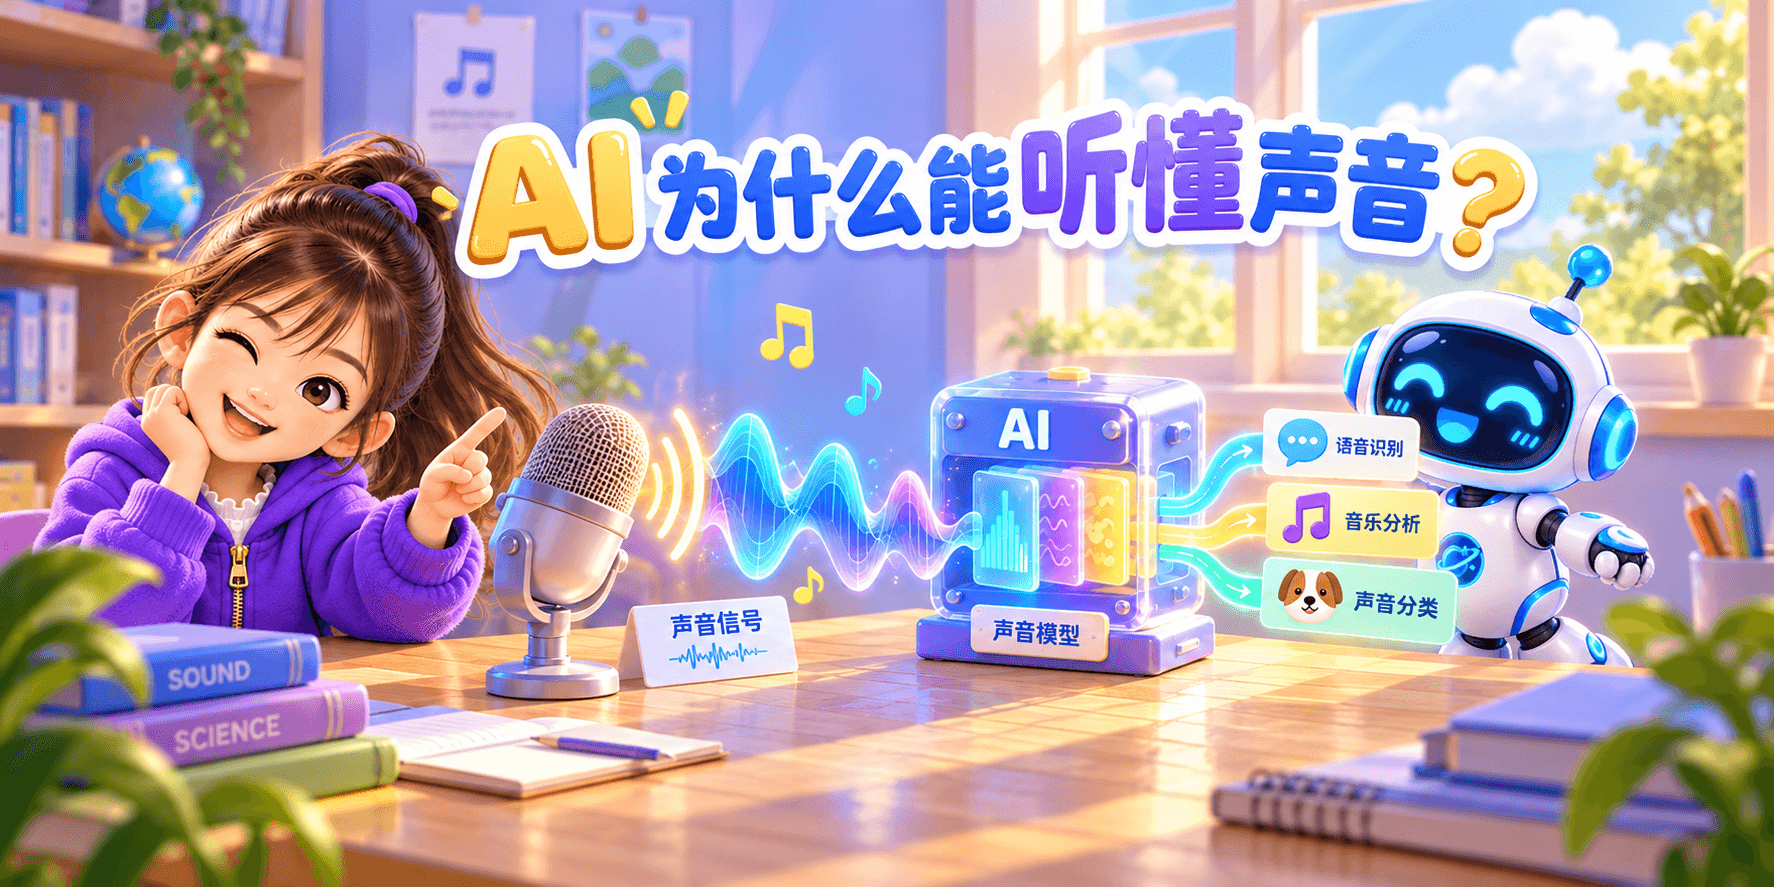
把过程摊开来看
- 采样声音成为数字
- 特征或表示保留时间变化
- 模型任务识别语音或声音类别
- 输出文字、标签等
声音模型处理随时间变化的音频信号。
识别说了什么、判断是什么声音、区分音乐节奏,是不同任务。模型可能利用频率与时间结构等信息,但不能直接读取说话人的全部意图。
噪声、口音和录音质量会影响结果。
轮到你来试一试
录音里有风声盖住一句话,模型应该编出确定原话吗?
想好了吗?点开看解释
不应,可以标出不清楚的部分并请人确认,避免把猜测当记录。
带走一个发现
声音模型处理随时间变化的音频信号。
试着遮住上面的图,把每一步讲给家人听。如果某一步说不清楚,就回到那张卡片再看一遍。