一起动脑筋 · 先看一个小故事
女孩给机器人一段带声音的视频,再问里面发生什么。不同输入需要先变成模型能处理的表示。
把过程摊开来看
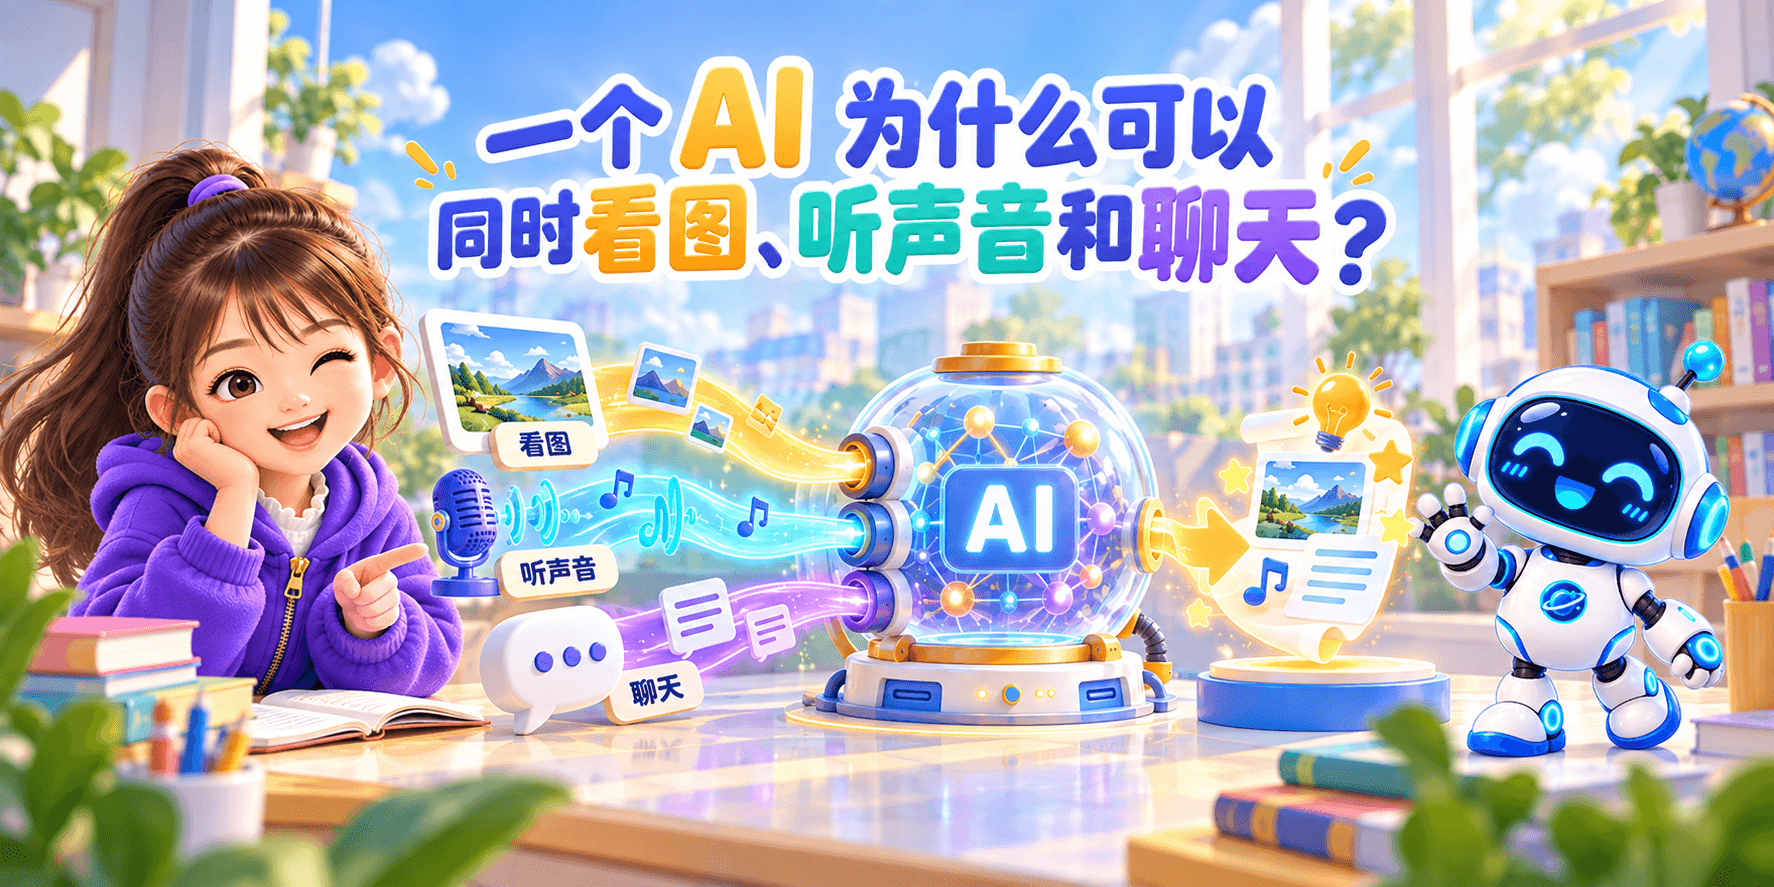
- 视觉表示来自画面
- 音频表示来自声音
- 语言问题确定任务
- 联合系统组织回答
能看、听、说的 AI 系统通常组合多种输入表示和输出能力。
有的模型在较统一结构中联合处理,有的由多个组件协作。用户看到一个对话框,不代表内部只有一个模型或只有一种计算。
各环节都有边界,语音识别错也会影响后续回答。
轮到你来试一试
图像清楚但声音听错,最后回答仍可能错吗?
想好了吗?点开看解释
可能。联合系统依赖多种信息,一处错误也可能传播到最后。
带走一个发现
能看、听、说的 AI 系统通常组合多种输入表示和输出能力。
试着遮住上面的图,把每一步讲给家人听。如果某一步说不清楚,就回到那张卡片再看一遍。