一起动脑筋 · 先看一个小故事
机器人找最大值时总拿 0 当起点。女孩拿出三张负数卡,它立刻露出了问题。
把过程摊开来看
- 普通例子2、5、3
- 边界例子只有一个值
- 特殊数据全是负数
- 重复数据最大值出现多次
边界测试针对最容易被默认假设漏掉的输入。
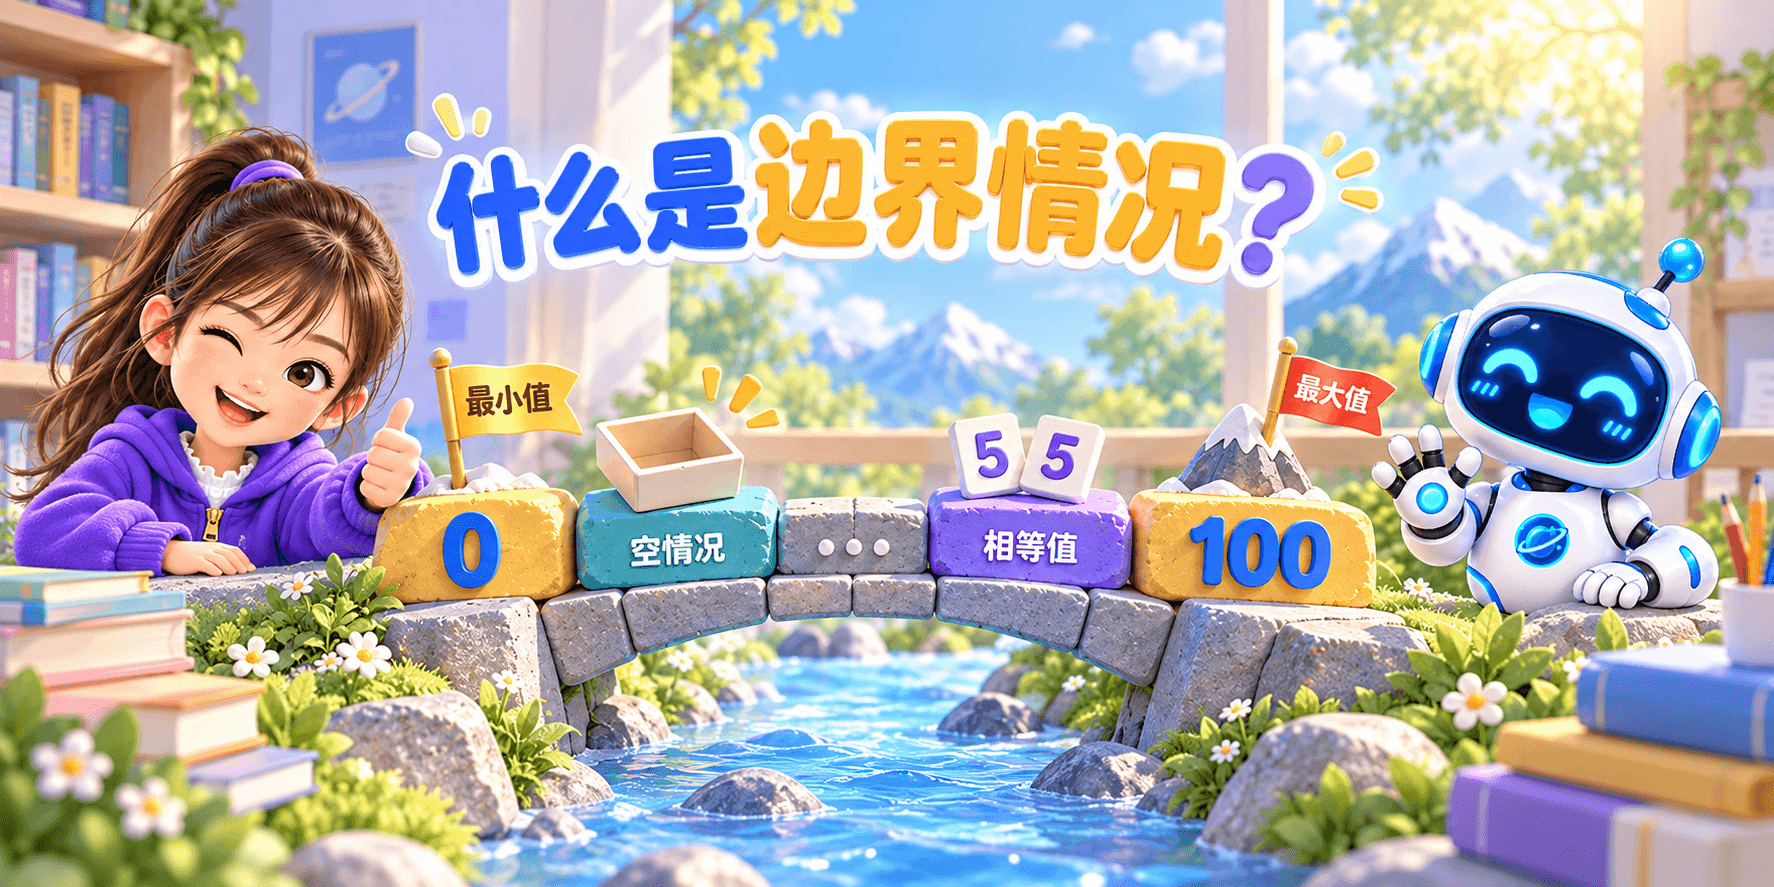
要根据题目允许范围选择,例如最小数量、最大数量、相等值和恰好等于阈值的数。
01什么叫边界情况?
边界情况(Edge Case)是位于问题“边缘”的输入。
例如数组长度规定 1 到 n,那么长度 1 和最大允许长度就是重要边界。
02最常见的边界有哪些?
最小规模
0 或 1 个元素(若题目允许)。
最大规模
接近题目上限。
极端值
最小 / 最大整数。
特殊结构
全相等、全递增、全递减。
03为什么下标特别容易出边界问题?
长度为 n 的数组合法下标是:
0 到 n - 1
因此 i < n 和 i <= n 可能只差一个字符,却决定是否越界。
04除法有什么边界?
除数为 0 是典型边界。
if (b != 0) {
    result = a / b;
}05搜索有什么边界?
- 起点就是终点
- 完全没有路径
- 只有一个节点
- 图不连通
06为什么最大数据也要测试?
因为小数据正确,不代表不会:
- 超时
- 整数溢出
- 递归太深
- 内存超限
07怎样建立边界检查习惯?
你已经知道了什么
- 边界情况位于输入和规则的边缘。
- 最小规模、最大规模、极端值都值得测试。
- 数组下标、除零、空数据是常见风险点。
- 最大数据还能暴露复杂度和溢出问题。
- 主动构造边界测试是重要解题习惯。
下一篇:样例通过了,为什么还是错?
轮到你来试一试
最高分可以为负时,最大值初始化为 0 有什么风险?
想好了吗?点开看解释
程序可能输出不存在的 0。非空集合可用第一项初始化。