一起动脑筋 · 先看一个小故事
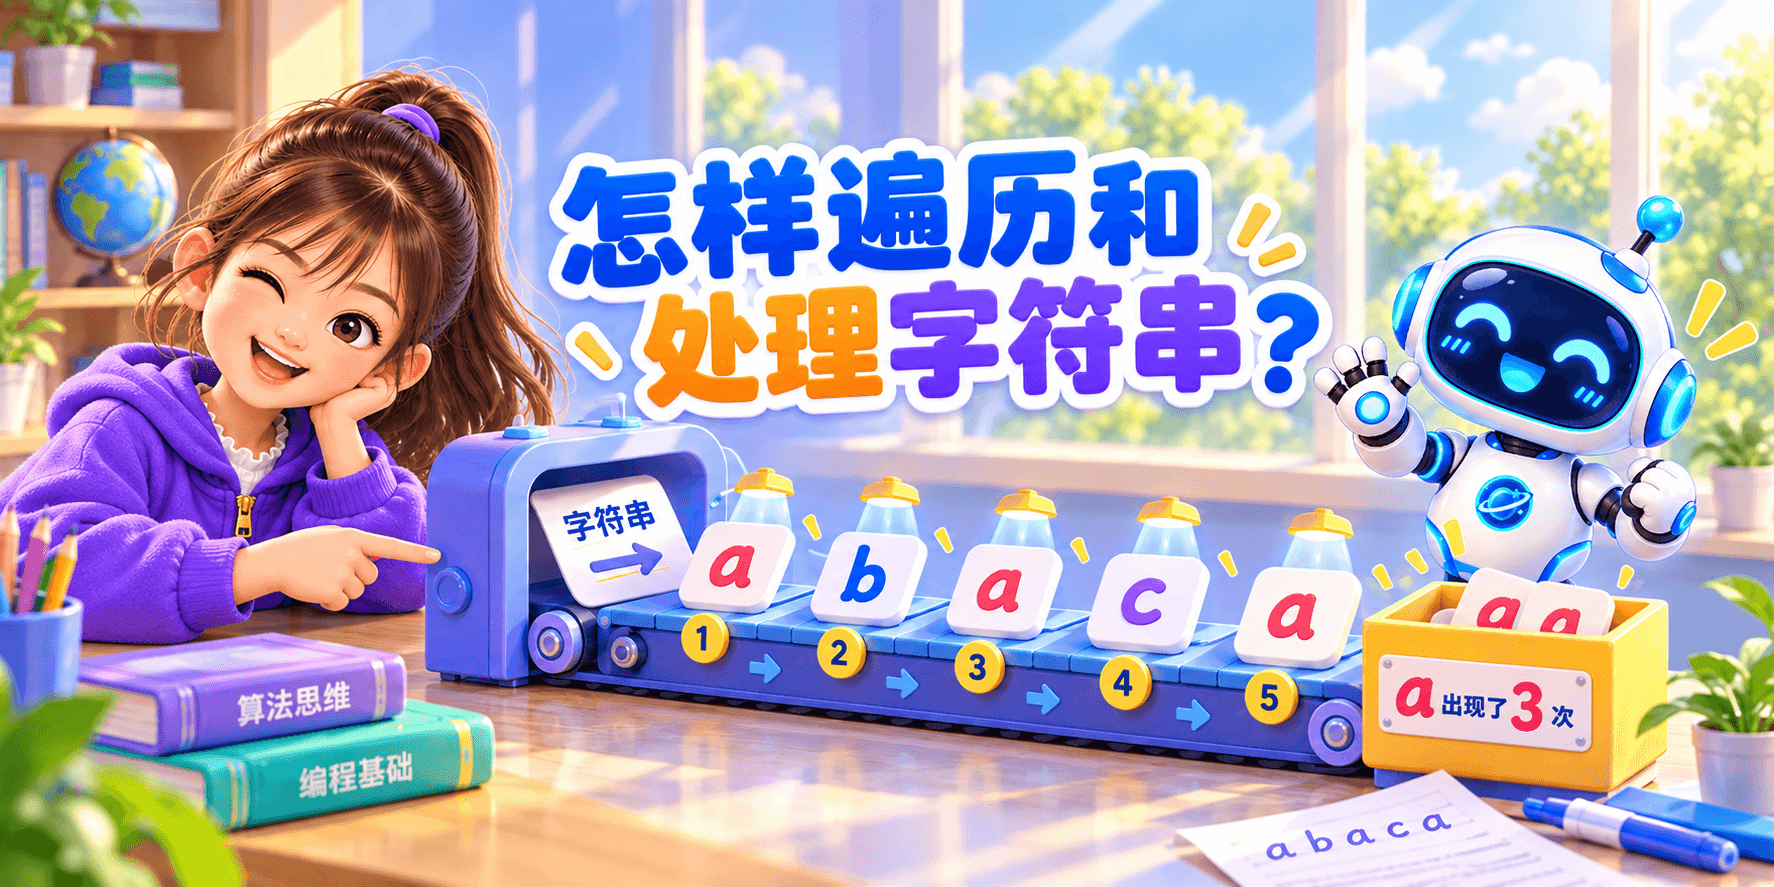
女孩想数 BANANA 里有几个 A。机器人从左往右,每找到一个就加一笔。
把过程摊开来看
- B计数 0
- A计数 1
- 继续 NANA再遇两个 A
- 结果3
遍历字符串可以逐项检查并统计。
准备一个计数器,只有当前字符符合条件时才加 1。找 A 的规则要明确是否也包括小写 a。
01怎样逐个访问字符串?
std::string s = "code";

for (std::size_t i = 0; i < s.size(); i++) {
    std::cout << s[i] << '\n';
}
会依次输出 c、o、d、e。
02也可以用范围 for
for (char c : s) {
    std::cout << c;
}
这种写法适合只关心每个 char 值、不需要下标的场景。
03怎样统计某个字符出现次数?
int count = 0;

for (char c : s) {
    if (c == 'a') {
        count++;
    }
}
每遇到一个 'a' 就让计数器加 1。
04怎样修改字符串里的字符?
std::string s = "cat";
s[0] = 'b';
修改后字符串变成 "bat"。
也可以使用引用遍历:
for (char& c : s) {
    // 可以直接修改 c
}05怎样找一个子串?
std::string s = "computer";
auto pos = s.find("put");如果找到,pos 是子串第一次出现的位置;如果没找到,结果是 std::string::npos。
06UTF-8 中文为什么不能这样简单遍历?
如果字符串包含 UTF-8 中文或 emoji:
std::string s = "你好";用 char 遍历时,通常是在逐个读取 UTF-8 编码字节,而不是一次得到一个完整汉字。
07遍历字符串时也会越界吗?
会。合法下标仍然是:
0 到 s.size() - 1(当字符串非空时)
s[s.size()] 不应该被当作普通可访问字符位置来使用。
如果希望运行时边界检查,可以使用 s.at(i)。
你已经知道了什么
std::string可以用下标或范围 for 遍历。- 遍历可以用于统计、查找、修改。
find可以查找子串。- 字符串下标同样要避免越界。
- UTF-8 下按 char 遍历的是字节,不一定是完整 Unicode 字符。
下一篇:数组能帮我们解决哪些问题?
轮到你来试一试
AaA 中只数大写 A,会得到 3 吗?
想好了吗?点开看解释
得到 2。中间的小写 a 与大写 A 不同。若希望两者都算,必须明确调整规则。